
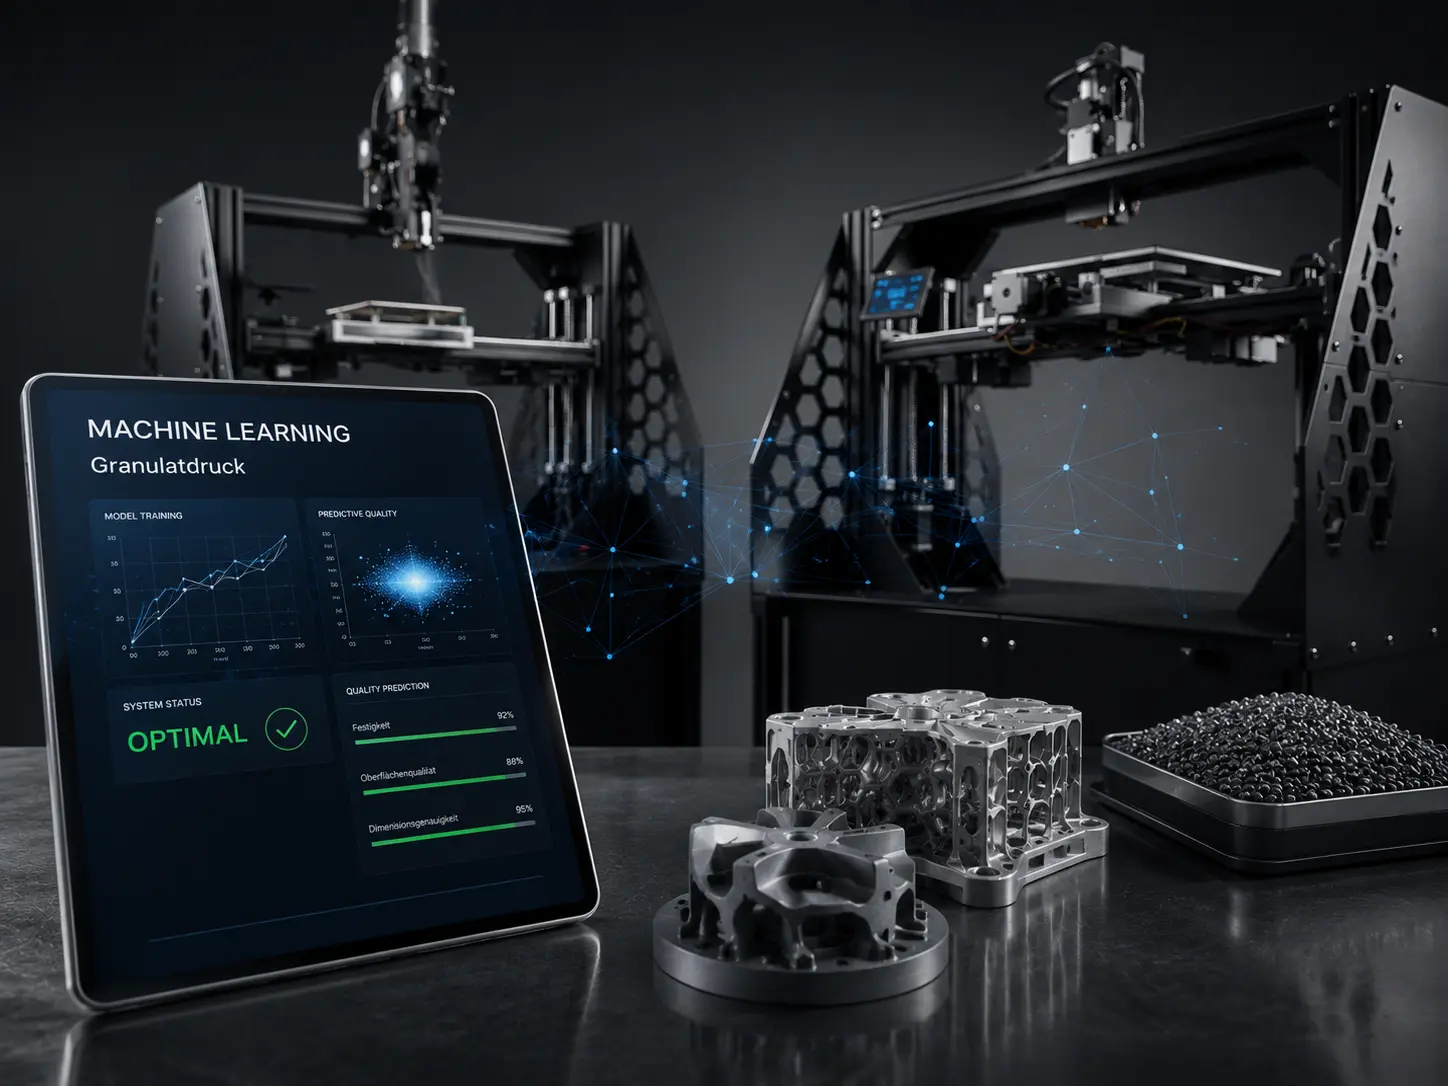
El machine learning en S2S-Systemdrucker GmbH es un tema amplio y muy específico, y además uno que puede hacer fundamentalmente más eficiente la impresión 3D a partir de granza. En este artículo explicamos cómo empleamos modelos de machine learning para encontrar la parametrización óptima de materiales exigentes como las ferritas, las cerámicas técnicas o las mezclas de materiales, y por qué nuestro planteamiento apuesta deliberadamente por el machine learning clásico en lugar de la IA generativa.
Qué es el machine learning, explicado en breve
Dicho de forma muy simplificada, el machine learning funciona así: mediante ciclos de entrenamiento iterativos y sistemas de ecuaciones matemáticas se entrena una red neuronal. La red entrenada puede después tomar decisiones o hacer predicciones a partir de un número cualquiera de parámetros de entrada, y lo hace tanto mejor cuantos más datos de entrenamiento de alta calidad estén disponibles.
Para la impresión 3D esto resulta interesante precisamente cuando se trata de una tarea que de forma clásica exige mucha experiencia, mucho tiempo y series de ensayos iterativas: la parametrización.
El reto: cada material y cada requisito son distintos
Un proyecto típico en nuestra casa empieza así: una empresa se dirige a nosotros y dice: «necesitamos estas y aquellas propiedades en la pieza impresa, y todo ello debe hacerse con este material concreto».
Entonces empieza nuestro verdadero trabajo: ¿cómo parametrizamos el equipo? ¿Cómo ajustamos la granza, la mezcla, los caudales de aportación? Precisamente en la impresión de granza con materiales técnicos, el espacio de parámetros es enorme: temperaturas, comportamiento del caudal, proporciones de mezcla y propiedades del material se influyen entre sí. De forma clásica, uno se aproxima al ajuste óptimo mediante series de ensayos. Eso funciona, pero cuesta tiempo y material.
Nuestro planteamiento: aprender de cada proyecto
Aquí es donde entran nuestros modelos de machine learning. Disponemos de un caudal creciente de datos: proyectos cerrados, nuestra base de datos de materiales, nuestra base de datos de parámetros. Sobre esa base entrenamos modelos que aprenden justamente esas relaciones.
En un proyecto nuevo esto tiene el siguiente aspecto: damos al modelo los parámetros de entrada del proyecto del cliente, es decir, las propiedades deseadas de la pieza, el material y las condiciones de contorno. El modelo entrenado analiza esas entradas y propone, a partir de su entrenamiento, una parametrización: proporciones de mezcla, caudales de aportación y otras magnitudes de proceso. En lugar de empezar de cero, partimos de una recomendación fundamentada y basada en datos, y acortamos considerablemente el camino hasta el ajuste óptimo.
El peligro del sobreajuste y cómo lo afrontamos
Quien trabaja con machine learning debe conocer y tomarse en serio un problema: el sobreajuste (overfitting). Consiste en que un modelo aprende de memoria, por así decirlo, los datos de entrenamiento en lugar de generalizar las relaciones subyacentes. La consecuencia: con datos conocidos ofrece resultados excelentes, pero falla ante constelaciones nuevas y desconocidas. Precisamente con datos de proceso de fabricación, que por su naturaleza no existen en cantidades ilimitadas, ese peligro es real.
Por eso hemos incorporado desde el principio mecanismos en nuestros procesos de entrenamiento que impiden el sobreajuste, para que nuestros modelos ofrezcan recomendaciones fiables también ante nuevas combinaciones de materiales y nuevos requisitos, y no se limiten a reproducir el pasado.
Importante: machine learning clásico en lugar de IA generativa
Un punto que nos importa: el machine learning es formalmente una rama de la inteligencia artificial, pero lo que empleamos aquí no tiene nada que ver con lo que hoy suele entenderse por «IA», es decir, modelos de lenguaje o IA generativa. Nuestros procesos de machine learning se basan en fórmulas matemáticas y en procedimientos de entrenamiento claramente definidos. La red neuronal amplía su conocimiento a lo largo de curvas de aprendizaje que dirigimos de forma selectiva y ajustamos a puntos definidos.
La diferencia decisiva: el proceso está en nuestras manos. El comportamiento de los modelos es comprensible, el entrenamiento está controlado y los resultados son reproducibles. Para el uso industrial, donde la fiabilidad importa más que una demostración espectacular, ese es precisamente el planteamiento correcto.
Conclusión
El machine learning convierte nuestra experiencia de proyecto en una herramienta activa: cada proyecto cerrado, cada punto de datos de la base de materiales y de parámetros mejora las recomendaciones para el siguiente. Para nuestros clientes eso significa fases de arranque más cortas, menos consumo de material en series de ensayos y resultados reproducibles con mayor rapidez, también y sobre todo con materiales exigentes.
¿Tiene un proyecto con requisitos especiales de material? Hable con nosotros: puede que nuestro modelo ya tenga la parametrización adecuada.